
Computer vision este domeniul care extrage informații din imagini și secvențe video. Într-o aplicație de firmă, rezultatul poate fi o categorie, o regiune în care apare un obiect, o zonă delimitată la nivel de pixeli sau textul recunoscut într-un document. Utilitatea se stabilește după operațiunea pe care informația o susține, nu după simpla existență a unei camere.
Pentru un depozit, întrebarea poate fi dacă un colet este prezent în zona de verificare. Pentru o echipă care prelucrează documente, poate fi necesar textul dintr-o scanare. Pentru un catalog, sarcina poate fi clasificarea fotografiilor de produs. Sunt proiecte diferite, cu date, rezultate și teste diferite.
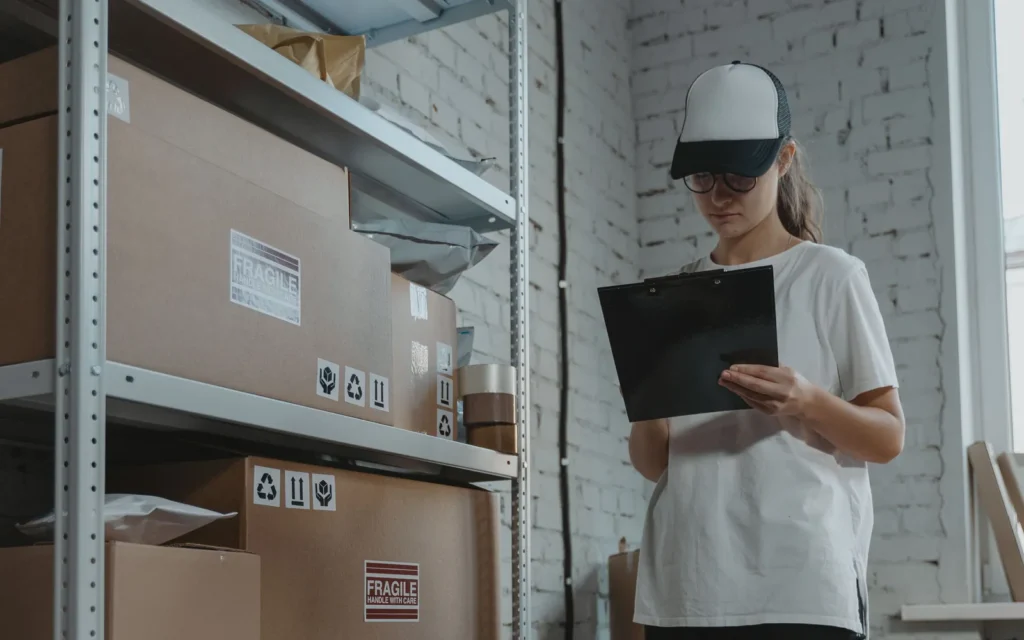
În acest ghid folosim un scenariu propriu de verificare a coletelor și scheme demonstrative. Nu prezentăm rezultate ale unui detector instalat la un client. Fotografiile arată activități de depozit, documente și conectivitate; contururile explicative sunt desenate separat în cod, fără modificarea fotografiilor sau atribuirea unei performanțe AI persoanelor ilustrate.
Ce este computer vision și cum se leagă de inteligența artificială?
Analiza imaginilor include metode clasice și modele învățate din date
O imagine digitală conține valori ale pixelilor, nu o listă gata făcută de obiecte și relații. Un sistem de viziune calculează reprezentări și rezultate potrivite sarcinii. Poate folosi operații geometrice, caracteristici vizuale și reguli, modele de machine learning sau o combinație a acestora. Computer vision nu este sinonim cu o singură arhitectură neuronală.
Harta despre tipurile de inteligență artificială separă tehnologia de sarcină. Un model care interpretează imagini și text poate face parte dintr-o aplicație vizuală, dar interfața conversațională nu stabilește singură calitatea localizării sau citirii. Proiectul are nevoie de o definiție precisă a rezultatului și de exemple verificate.
Alege ieșirea necesară, nu doar eticheta computer vision
- Clasificare
O etichetă pentru imaginea ori regiunea analizată.
- Detectare
Obiecte individuale, clase și regiuni de localizare.
- Segmentare
Clase sau instanțe asociate pixelilor, după schema proiectului.
- OCR
Text recunoscut din imagine, apoi verificat și prelucrat separat.
În exemplul nostru, camera observă o zonă de recepție. Definim ce înseamnă colet, când este observat și ce rezultat trebuie transmis operatorului. Nu cerem modelului să decidă toate evenimentele din depozit. Începem cu informația necesară unei activități delimitate și cu situațiile în care rezultatul trebuie verificat.
Clasificare, detectare și segmentare: ce diferențe au rezultatele?
Eticheta imaginii, dreptunghiul obiectului și conturul pixelilor răspund altor întrebări
Clasificarea atribuie o categorie imaginii ori regiunii analizate. Detectarea propune obiecte individuale, clase și localizări, adesea prin dreptunghiuri. Segmentarea atribuie clase ori instanțe pixelilor, după tipul sarcinii. Documentația TensorFlow separă explicit clasificarea imaginilor de segmentarea la nivel de pixeli; alegerea depinde de informația cerută aplicației.
Schemă originală: obiectele și regiunile lor nu sunt același lucru
- A
- B
- C
O etichetă „colete prezente” nu oferă automat numărul ori poziția coletelor. Mai multe dreptunghiuri pot descrie obiecte suprapuse, duplicate sau regiuni diferite ale aceleiași scene. Aplicația trebuie să știe ce ieșire primește și cum o transformă într-un rezultat verificabil. Numărul de obiecte și numărul de evenimente sunt alte unități de măsură.
Segmentarea semantică grupează pixelii pe clase, iar segmentarea de instanțe distinge obiectele individuale dintr-o clasă. Pentru un flux care cere doar prezența unui colet, o mască detaliată poate fi inutilă. Pentru măsurarea unei zone vizibile, un dreptunghi poate include prea mult fundal. Cerința procesului decide reprezentarea potrivită.
Cum ajunge sistemul de la pixeli la un rezultat?
Reprezentarea vizuală este o componentă, nu întregul proces comercial
Metodele clasice pot compara forme, muchii, puncte caracteristice și alte proprietăți calculate. Documentația OpenCV descrie, de exemplu, detectarea de puncte și descriptorii vizuali. Acestea sunt mecanisme diferite de clasificarea semantică a unui obiect. Nu presupunem că fiecare operație asupra unei imagini cere antrenarea unui model profund.
În aplicațiile cu deep learning, reprezentările sunt învățate din date în timpul antrenării. La utilizare, modelul aplică parametrii și transformările definite pentru a produce ieșirea. Un rezultat nou nu înseamnă că sistemul s-a reantrenat automat pe imaginea tocmai primită. Antrenarea și inferența au proceduri și resurse separate.
Un model multimodal poate descrie o imagine în limbaj natural. Pentru o integrare cerem însă ieșirea necesară, verificăm corespondența cu imaginea și măsurăm erorile pe sarcina respectivă. O explicație fluentă nu ține locul unei localizări corecte, al textului citit exact sau al unei reguli de autorizare a operațiunii finale.
De ce camera și condițiile de captură contează în proiect?
Testăm informația disponibilă în scena reală, nu o imagine ideală izolată
Pentru scenariul de depozit propunem o zonă de observare definită și o poziție cunoscută a camerei. Verificăm iluminarea, reflexiile, distanța, mișcarea și obiectele care se acoperă reciproc. Dacă detaliul necesar nu este vizibil în cadru, schimbarea modelului nu înlocuiește o captură adecvată. Cerința trebuie discutată împreună cu fluxul fizic.
Rezoluția fișierului nu descrie singură cât de bine este vizibil obiectul relevant. Un colet mic într-un cadru foarte larg poate ocupa puțină informație. Micșorarea, decuparea sau compresia înainte de analiză trebuie testate pentru acel obiect. Reprezentarea procesată este păstrată în evidența configurației, pentru a putea reproduce verificarea.
Pentru video stabilim momentul observației și latența acceptată de proces. Un rezultat sosit după trecerea obiectului poate fi corect ca imagine, dar nepotrivit operațional. Lipsa cadrelor, camera deconectată și întârzierile sunt stări tehnice distincte. Nu le înregistrăm ca dovadă că zona este goală sau că obiectul nu a existat.
Verificarea se face și în situațiile dificile prevăzute de activitate: ambalaje lucioase, etichete parțial acoperite și obiecte apropiate. Nu cerem operatorului să schimbe neobservat fluxul pentru a ajuta demonstrația. Dacă este necesară o poziție de captură controlată, aceasta devine o cerință explicită, cu efectul asupra modului de lucru discutat înainte de lansare.
Ce date și etichete sunt necesare pentru evaluare?
Definiția obiectului și împărțirea datelor se stabilesc înainte de comparație
Pregătim imagini autorizate care acoperă condițiile proiectului. Ghidul de etichetare precizează clasele, limitele obiectelor și cazurile de excludere. Pentru aceeași scenă, verificatorii trebuie să folosească aceeași definiție a coletului și a regiunii. Diferențele de adnotare se clarifică, nu sunt lăsate modelului să le rezolve printr-un scor agregat.
Cum transformăm o problemă vizuală într-un pilot
- 1 · Captură
Definim scena, camera, iluminarea și unitatea observată.
- 2 · Referință
Etichetăm date autorizate după aceeași definiție a rezultatului.
- 3 · Variantă de bază
Comparăm reguli, metode clasice și un model potrivit sarcinii.
- 4 · Test separat
Verificăm clasele și condițiile relevante, fără amestecarea loturilor.
- 5 · Flux operațional
Stabilim verificarea, evenimentul și operațiunea permisă.
În învățarea supervizată, exemplele etichetate susțin învățarea și evaluarea, dar lotul de test rămâne separat. Cadre aproape identice din aceeași secvență pot face comparația prea favorabilă dacă sunt împărțite neglijent. Alegem separarea după scena, perioada și tipul de variație pe care proiectul trebuie să le verifice.
Transformările pentru augmentare pot varia exemplele de antrenare, în limite realiste pentru sarcină. Ele nu adaugă automat observații independente ale tuturor condițiilor din teren. Verificăm dacă transformarea păstrează sensul etichetei și geometria necesară. Un text întors sau o regiune tăiată poate schimba tocmai informația pe care vrem să o recunoaștem.
În ghidul de adnotare precizăm ce facem cu un obiect vizibil doar parțial, cu o cutie deschisă ori cu un obiect care nu aparține claselor urmărite. Exemplele-limită ajută verificatorii să aplice aceeași regulă. Un caz în afara ariei proiectului primește o stare clară, nu o etichetă aleasă forțat pentru a completa rezultatul.
Cum se folosesc OCR și urmărirea obiectelor în aplicații?
Textul, traseul și identitatea sunt rezultate diferite
OCR extrage text din imagine. Într-un document, următorul pas poate fi recunoașterea entităților și extragerea informațiilor, urmată de validare. Citirea unei denumiri nu identifică automat partenerul din CRM, iar citirea unei date nu stabilește rolul ei. Geometria și ordinea textului pot conta la fel de mult ca șirul recunoscut.
Trackingul urmărește regiuni sau obiecte de-a lungul cadrelor. Exemplul de MultiTracker din documentația OpenCV arată inițializarea unor regiuni și actualizarea lor în secvență. Conceptul nu este echivalent cu recunoașterea identității unei persoane. În ghidul nostru, obiectele urmărite sunt colete, fără funcții biometrice sau evaluarea angajaților.
Pentru numărare, aplicația poate avea nevoie de o regulă care confirmă traversarea unei zone, nu de suma detecțiilor din fiecare cadru. Același colet poate apărea repetat. Definim când începe și se încheie un eveniment, cum tratăm pierderea temporară a urmăririi și ce cazuri ajung la operator pentru verificare.
Cum măsurăm un model de computer vision fără comparații înșelătoare?
Indicatorul trebuie citit împreună cu sarcina, pragul și condițiile testului
Pentru clasificare verificăm clasele corecte, ratările și alarmele false. Pentru detectare contează și localizarea. Intersecția peste reuniune, numită IoU, compară geometric regiunea propusă cu referința. Protocolul stabilește pragul și regulile de potrivire, inclusiv tratarea propunerilor duplicate. Un procent fără aceste condiții nu descrie complet rezultatul.
Ce declarăm când raportăm rezultatele unui detector
- Clasa
Ce obiect trebuia identificat și cum sunt definite excepțiile.
- Localizarea
Cum se compară regiunea propusă cu referința; criteriul geometric este explicit.
- Pragul
Ce scor acceptăm și ce ratări ori alarme false rezultă.
- Protocolul
Setul de test, regulile de potrivire, dublurile și indicatorul calculat.
Documentația TensorFlow pentru evaluarea detectorilor separă protocoale și indicatori precum AP sau mAP. Aceștia nu se confundă cu precizia măsurată la un singur prag de scor. Pentru o comparație corectă folosim aceleași date, clase, condiții de prelucrare și reguli. Nu transferăm performanța unui set public către camera firmei fără testul relevant.
Analizăm separat obiectele mici, mișcarea, iluminarea dificilă și tipurile de ambalaj relevante. Urmărim și consecința operațională: evenimente corect confirmate, timp de verificare și operațiuni oprite justificat. O predicție corectă pe un cadru nu este automat un eveniment comercial corect, iar o regiune omisă nu trebuie ascunsă într-o medie favorabilă.
Cum legăm analiza vizuală de gestiune, CRM sau aplicația firmei?
Detecția propune informația; aplicația aplică regula și verifică efectul
Integrarea primește rezultatul împreună cu momentul, sursa și configurația relevantă. Regula procesului stabilește dacă se afișează o alertă, se pregătește o propunere sau se cere verificarea unui operator. Pentru automatizări business cu AI, diferența dintre observare și operațiunea autorizată este explicită în specificație.
În scenariul propus, prezența unui colet poate iniția o verificare, dar nu modifică singură stocul. Sistemul trebuie să asocieze obiectul cu operațiunea potrivită și să respecte drepturile utilizatorului. Un scor al modelului nu reprezintă aprobarea unei schimbări, nici identificarea certă a produselor aflate în interiorul ambalajului.
Salvarea are nevoie de prevenirea dublurilor și de confirmarea efectului. Dacă aceeași observație ajunge repetat prin integrare, operațiunea nu se multiplică. Erorile, întârzierile și rezultatele neconcludente au stări clare. Operatorul poate vedea ce s-a observat, ce s-a propus și ce a fost efectiv schimbat în sistem.
Ce monitorizăm după lansarea unei aplicații vizuale?
Captura, modelul și operațiunea finală au controale proprii
Google recomandă monitorizarea diferențelor dintre datele și transformările de la antrenare și cele din utilizare. Aplicăm această distincție pilotului: o cameră mutată, un ambalaj nou sau o prelucrare diferită a imaginii cer reverificarea cazurilor afectate. Păstrăm versiunile configurației și comparația cu referința, în loc să schimbăm discret pragurile.
Patru lucruri diferite de monitorizat în exploatare
- Captură disponibilă
Imagine valabilă, cameră conectată și momentul observării.
- Configurație cunoscută
Versiunile modelului, regulilor și transformărilor folosite.
- Rezultat verificabil
Predicție, excepție și dovada relevantă pentru operator.
- Efect controlat
Eveniment confirmat și operațiune executată în limitele aprobate.
În proiectarea pentru protecția datelor din aplicația AI, definim imaginile necesare, accesul la ele și păstrarea dovezii pentru verificare. Nu colectăm automat întreaga activitate video dacă procesul are nevoie doar de observații delimitate. Interfața și exporturile aplică regulile de acces ale firmei.
Resursele se măsoară pe configurația efectivă: timp de captură și prelucrare, transfer, inferență și răspunsul integrației. Alegerea între procesare locală și la distanță se face după aceste cerințe și fluxul de date. Nu presupunem că orice analiză în timp real necesită același hardware sau aceeași arhitectură de găzduire.
Cum alegem primul proiect de computer vision?
Începem cu o sarcină observabilă și repetabilă, cu un responsabil care poate verifica rezultatul. Stabilim costul erorilor, datele disponibile și o variantă de bază. Un cititor de coduri, o regulă geometrică sau o schimbare de captură poate fi mai potrivită decât un model complex pentru o cerință bine delimitată.
Pilotul include condiții normale și excepții, apoi compară rezultatul tehnic cu munca reală. Un dashboard cu rapoarte operaționale poate arăta observațiile valabile, excluderile, verificările și evenimentele confirmate. Numitorii sunt vizibili: nu raportăm doar cazurile în care camera și modelul au returnat un rezultat convenabil.
Înainte de extindere, firma primește criteriile de acceptare, erorile identificate și procedura de operare. Schimbările de cameră, format ori model se verifică pe cazurile relevante. Această ordine permite îmbunătățirea componentei care limitează procesul, fără a transforma fiecare problemă într-o înlocuire integrală a soluției.
Comparația economică include verificarea umană, întreținerea capturii, prelucrarea și integrarea, nu numai timpul unei predicții. Urmărim activitatea efectiv simplificată și erorile care mai cer intervenție. Obiectivul pilotului este o decizie informată despre fluxul propus, cu responsabilități și condiții de utilizare vizibile pentru echipă, nu doar o imagine cu dreptunghiuri colorate.
Cum abordăm la WebHat o aplicație bazată pe imagini sau video?
Pornim de la proces, nu de la o demonstrație aleasă pentru efect vizual. Definim intrarea, rezultatul și operațiunea finală, apoi verificăm datele autorizate și integrarea existentă. Specificația separă funcțiile implementate în pilot de extinderile propuse și precizează cine validează situațiile cu impact asupra evidențelor firmei.
Pentru aplicații custom cu integrare AI, putem proiecta fluxul de captură, serviciul de analiză, zona de verificare și conectarea la sistemele companiei. Alegerea componentelor urmează rezultatul testului și cerințele de operare. O explicație clară a erorilor este la fel de importantă ca demonstrarea unui exemplu reușit.
Pentru o discuție utilă, pregătește tipul imaginilor, scena, rezultatul dorit, frecvența observațiilor și destinația informației. Precizează și ce trebuie să se întâmple când imaginea lipsește ori rezultatul cere verificare. Pe această bază se poate estima un pilot concret și un traseu de integrare potrivit activității firmei.
Întrebări frecvente despre computer vision pentru firme
Orice analiză de imagine este deep learning?
Nu. Computer vision include și metode clasice bazate pe geometrie, caracteristici vizuale și reguli. Modelul învățat din date se alege când contribuie la cerința și rezultatul testat. Proiectul poate combina metode diferite pentru etape distincte ale aceluiași flux.
O clasificare îmi spune câte obiecte sunt în cadru?
O etichetă pentru imagine nu oferă automat numărul și poziția obiectelor. Pentru această cerință se evaluează detectarea ori altă metodă potrivită. Numărarea evenimentelor într-un video cere suplimentar o definiție a evenimentului și tratarea aparițiilor repetate.
Trackingul coletelor identifică și persoanele din imagini?
Sunt sarcini diferite. Ghidul descrie urmărirea regiunilor unor obiecte între cadre, nu identificarea persoanelor. Funcțiile biometrice și utilizările lor cer o analiză distinctă a scopului, datelor și condițiilor aplicabile, înainte de orice propunere de implementare.
Putem folosi camera existentă?
Verificăm poziția, vizibilitatea detaliilor, accesul tehnic și condițiile în care este capturată imaginea. Un test pe date reprezentative arată dacă intrarea disponibilă susține sarcina. Rezoluția declarată a camerei nu înlocuiește această verificare pentru scena concretă.
Trebuie să trimitem toate imaginile către un serviciu extern?
Arhitectura poate include procesare locală sau la distanță, după model, hardware, latență și regulile datelor. Fluxul stabilește ce se transferă și ce se păstrează. Decizia este parte a proiectării și evaluării, nu o condiție identică pentru toate aplicațiile vizuale.
Ce rezultat ar trebui să primim dintr-un pilot?
Definiția sarcinii, datele și configurația testate, rezultatele pe condiții relevante, erorile observate și procedura de verificare. Raportul arată și integrarea finală: ce informație propune sistemul, cine o aprobă și cum se confirmă efectul operațional.



