Tipurile de inteligență artificială se înțeleg corect atunci când separăm tehnologia folosită, sarcina, capacitățile și autonomia sistemului. Machine learning, AI generativă, modele lingvistice și agenți AI nu sunt patru variante care se exclud. O singură aplicație poate combina toate aceste elemente.
Imaginează-ți un asistent care citește o solicitare, găsește datele clientului și pregătește o ofertă. Prelucrarea textului ține de limbaj natural; redactarea poate folosi un model generativ; consultarea CRM-ului cere o integrare; trimiterea ofertei depinde de permisiunile aplicației. Eticheta „AI” nu descrie singură nici arhitectura, nici nivelul de control.
Acest ghid arată cum se leagă principalele categorii și cum le folosim în alegerea unor aplicații custom cu integrare AI. Exemplele de mai jos explică soluții posibile, nu rezultate atribuite unor clienți sau teste de performanță efectuate de WebHat.
De ce există mai multe clasificări ale inteligenței artificiale?
În definițiile NIST, un sistem AI produce, pentru anumite obiective, ieșiri precum predicții, recomandări sau decizii care influențează un mediu fizic ori digital. Această definiție cuprinde mult mai mult decât un chatbot: de la analiza imaginilor până la planificarea acțiunilor.
Confuzia apare când amestecăm întrebări diferite. „Ce date prelucrează?” nu este aceeași întrebare cu „Cum a fost antrenat?” sau „Are voie să modifice o înregistrare?”. De aceea, o comparație utilă păstrează criteriile separate.
Cinci întrebări, cinci criterii de clasificare
- 01 · Tehnologie
Cum este construit? Reguli, machine learning, rețele neuronale.
- 02 · Sarcină și date
Ce prelucrează? Text, imagini, sunet sau date structurate.
- 03 · Capacități
Cât de larg și la ce nivel poate rezolva sarcini?
- 04 · Model și stare
Cum produce rezultatul și ce context ori istoric folosește?
- 05 · Autonomie
Doar răspunde, propune pași sau execută operațiuni autorizate?
Exemplu: un asistent pentru documentele firmei poate fi bazat pe deep learning, specializat în limbaj, generativ, conectat la o bază de cunoștințe și limitat la propuneri care cer aprobare. Descrierile sunt compatibile, nu concurente. Niciuna nu înlocuiește verificarea accesului, a datelor și a răspunsului final.
AI, machine learning și deep learning: care este relația?
Inteligența artificială este domeniul larg; machine learning este o familie de metode din acest domeniu; deep learning este o ramură a machine learning bazată pe rețele neuronale cu mai multe straturi. Există și sisteme AI care folosesc căutare, planificare sau reprezentarea explicită a cunoștințelor. Nu orice regulă automată este însă, prin ea însăși, AI.
În machine learning, un algoritm ajustează un model pornind de la date sau experiență. În loc să scriem manual fiecare combinație care poate indica o cerere urgentă, putem antrena un clasificator pe exemple etichetate. Modelul trebuie apoi evaluat pe exemple care nu au fost folosite pentru ajustarea lui.
Deep learning folosește straturi succesive pentru a învăța reprezentări ale datelor. CNN-urile sunt o familie folosită în analiza imaginilor; RNN-urile tratează secvențe prin stare recurentă; Transformer-ele folosesc mecanisme de atenție. Arhitecturile au utilizări diferite și pot fi combinate. Numărul straturilor nu decide singur dacă o aplicație rezolvă bine cerința firmei.
Trei moduri de învățare, trei semnale diferite
- Supervizată
Exemple cu rezultat cunoscut → model → predicție pe date noi.
- Nesupervizată
Date fără țintă etichetată → structură → grupuri sau reprezentări.
- Prin întărire
Stare → acțiune → recompensă → ajustarea strategiei.
Învățarea supervizată, nesupervizată și prin întărire descriu moduri de învățare, nu trei sectoare comerciale. Mai există învățare auto-supervizată, în care țintele de antrenare sunt construite din structura datelor, și abordări semisupervizate. Un proiect poate parcurge mai multe etape: preantrenare pe un corpus larg, adaptare și evaluare pe sarcina concretă.
Tipuri de AI după datele și problemele prelucrate
Limbaj natural: texte, căutare și conversații
Procesarea limbajului natural, sau NLP, cuprinde metode pentru analiza și generarea limbajului. O firmă poate clasifica solicitări, extrage nume de produse, identifica intenția unui mesaj sau produce rezumate. Un LLM este un model lingvistic de mari dimensiuni; nu toate soluțiile NLP folosesc LLM-uri.
Pentru răspunsuri din informații interne, modelul poate primi fragmente recuperate din surse aprobate. Aceasta este logica explicată în ghidul despre chatbotul AI conectat la documentele firmei prin RAG. Calitatea răspunsului depinde și de documentele selectate, de versiunea lor și de dreptul utilizatorului de a le consulta.
Viziune computerizată: informații din imagini și video
Computer vision poate clasifica o imagine, localiza obiecte, delimita zone sau urmări mișcarea. Într-un depozit, sarcinile pot include numărarea coletelor ori verificarea prezenței unei etichete. Detectarea unui obiect, citirea textului și recunoașterea identității unei persoane sunt probleme diferite.
Rezultatele trebuie testate cu iluminarea, unghiurile, produsele și camerele din situația reală. O demonstrație pe fotografii selectate nu descrie automat comportamentul în toate turele de lucru.
Audio: transcriere, sinteză vocală și analiză de sunet
Un sistem speech-to-text transformă vorbirea în text; text-to-speech produce voce pornind de la text. Un asistent vocal mai are nevoie de gestionarea conversației, reguli pentru date și conectare la operațiunile disponibile. Recunoașterea vorbirii și confirmarea unei programări sunt componente distincte.
Date structurate: estimări, clasificări și anomalii
Modelele pot utiliza tabele cu vânzări, stocuri sau timpi de intervenție pentru a estima valori, grupa comportamente ori semnala abateri. Aici sunt utile și metode clasice, nu doar modele generative. Alegerea începe cu variabila pe care o măsurăm și cu istoricul disponibil.
Robotică și AI întrupată
Într-un sistem robotic, percepția este legată de acțiuni în mediul fizic. Senzorii, planificarea, controlul mișcării și mecanismele de siguranță lucrează împreună. „Embodied AI” descrie cercetarea și sistemele în care interacțiunea cu mediul contează pentru comportament; nu înseamnă doar adăugarea unui chatbot unui robot.
AI multimodală
Multimodalitatea înseamnă lucrul cu mai multe forme de informație, de exemplu text și imagini. Un flux poate analiza fotografia unui produs împreună cu descrierea și codul său. Trebuie precizat ce intrări și ieșiri acceptă modelul concret: suportul pentru imagini nu implică automat suport pentru orice tip de fișier, sunet sau video.
ANI, AGI și ASI: clasificarea după capacități
Aceste concepte descriu întinderea și nivelul abilităților, nu infrastructura pe care rulează aplicația. În lucrarea Levels of AGI, cercetătorii propun evaluarea separată a generalității, performanței și autonomiei. Cadrul ajută la comparații explicite, fără a transforma o etichetă într-o măsurătoare.
Capacitatea nu se măsoară prin permisiunile aplicației
- ANI · Specializare
Sarcini sau domenii definite. Verificăm performanța în aria aleasă.
- AGI · Generalitate
Capacități largi comparate cu niveluri umane, pe criterii și sarcini explicite.
- ASI · Superinteligență
Conceptul depășirii ample a capacităților umane pe un spectru larg.
ANI, inteligența artificială specializată, vizează sarcini sau domenii definite. Un model poate transfera cunoștințe între sarcini ori limbi și poate rămâne limitat în alte privințe. De aceea, nu definim AI specializată prin presupunerea că transferul este imposibil.
AGI desemnează capacități generale de învățare și rezolvare a problemelor, comparate cu performanța umană pe un spectru larg. Criteriile trebuie numite: ce sarcini, ce nivel, ce condiții și cât ajutor primește sistemul. Un scor ridicat la un singur test nu răspunde tuturor acestor întrebări.
ASI este conceptul de superinteligență care ar depăși amplu capacitățile umane pe un spectru larg de activități. În acest ghid este o categorie conceptuală, nu o funcție pe care o selectăm dintr-un abonament software. Alegerea unei aplicații pentru firmă se bazează pe sarcini măsurabile, nu pe o dată anticipată pentru AGI sau ASI.
AI reactivă, memorie limitată, teoria minții și conștiință
O altă taxonomie întâlnită în materialele introductive privește modul în care sistemul folosește starea și interacțiunea. Este o explicație conceptuală, nu un set universal de patru clase tehnice exclusive sau patru versiuni prin care trece obligatoriu fiecare model.
- Sisteme reactive: răspund la informația disponibilă în momentul curent, fără a urmări un istoric al sesiunii. „Fără memorie” în această descriere nu înseamnă că lipsesc codul, regulile sau parametrii învățați.
- Sisteme cu memorie limitată: folosesc o parte din istoricul sau starea relevantă pentru decizia curentă. Un context de conversație, o stare de lucru și o bază de date persistentă sunt mecanisme diferite, chiar dacă toate pot furniza informație despre trecut.
- Teoria minții: privește reprezentarea credințelor, intențiilor și perspectivelor altor participanți. Studiile cu LLM-uri evaluează sarcini și protocoale concrete; rezultatele lor trebuie citite în acei termeni.
- Conștiință de sine: se referă la întrebări despre experiență subiectivă și reprezentarea propriei existențe. Un răspuns fluent despre emoții sau despre sine nu constituie, singur, dovada acestor proprietăți.
Pentru o aplicație de business, întrebarea practică este unde se păstrează starea, cine o poate citi și cât timp este necesară. Salvarea unei conversații nu înseamnă automat că modelul își actualizează parametrii prin antrenare. Verificăm mecanismul concret, nu presupunem „învățare continuă” la fiecare mesaj.
AI generativă, modele discriminative, LLM și SLM
AI generativă produce conținut: text, imagini, sunet, cod sau alte ieșiri, în funcție de model. Într-o firmă poate pregăti un rezumat sau o variantă de răspuns. Datele exacte, calculele și acțiunile trebuie legate de sursele și regulile aplicației.
Modelele discriminative învață relația dintre intrare și o țintă, cum ar fi categoria unei solicitări. Distincția statistică generativ/discriminativ nu este aceeași cu împărțirea „creează versus prezice”: există și clasificatori generativi care produc predicții. Documentația scikit-learn despre analiza discriminantă ilustrează clasificarea pornind de la distribuțiile datelor pentru fiecare clasă.
Un model fundamental este antrenat pe date largi și poate fi adaptat unor sarcini ulterioare. Definiția, sistematizată de Stanford CRFM, descrie rolul lui de bază pentru alte aplicații. „Fundamental” nu înseamnă automat lingvistic, multimodal sau autorizat să acționeze asupra sistemelor firmei.
LLM și SLM descriu modele lingvistice de dimensiuni diferite. Pentru alegere contează sarcina, calitatea pe limba folosită, memoria necesară, timpul de răspuns și modul de găzduire. Nu folosim un prag universal de parametri pentru toate modelele numite „mici”.
Un SLM poate fi antrenat direct sau obținut prin alte procedee; distilarea este una dintre tehnici, nu definiția obligatorie. Cuantizarea reduce precizia numerică a reprezentării, nu este sinonimă cu reducerea numărului de parametri. Aceste diferențe afectează implementarea și trebuie evaluate pentru modelul ales.
Ce adaugă un agent AI față de un model sau un chatbot?
Un agent percepe informații din mediul său și selectează acțiuni. În formularea clasică din Artificial Intelligence: A Modern Approach, întâlnim agenți reflex, cu model intern, orientați pe obiective și bazați pe utilitate; învățarea poate fi adăugată acestor arhitecturi.
În aplicațiile cu LLM-uri, un agent poate utiliza instrumente pentru a căuta, calcula sau solicita operațiuni prin API. Modelul propune pași, dar aplicația trebuie să verifice identitatea, drepturile, argumentele și rezultatul fiecărei operațiuni. Un API disponibil nu înseamnă acces nelimitat.
Cum devine o propunere AI o acțiune controlată
- 1 · Cerere
Utilizator identificat și obiectiv clar.
- 2 · Informație
Surse și instrumente permise pentru acel utilizator.
- 3 · Propunere
Modelul pregătește pașii sau argumentele operațiunii.
- 4 · Control
Aplicația validează regulile și cere aprobarea necesară.
- 5 · Execuție
Operațiune autorizată, rezultat verificat și jurnal.
Un chatbot poate explica ce conține o ofertă. Un agent conectat la sisteme poate pregăti oferta din date aprobate, dacă are instrumentele și permisiunile necesare. Trimiterea către client poate rămâne condiționată de o aprobare explicită. Diferențele sunt dezvoltate în ghidul chatbot versus agent AI pentru firme.
Autonomia este o decizie de proiectare. O aplicație poate permite doar citirea, poate accepta propuneri sau poate executa anumite operațiuni clar delimitate. Creșterea autonomiei trebuie însoțită de teste, jurnal și mecanisme de oprire. Nu reprezintă o dovadă că modelul este AGI.
Trei exemple: cum se combină tipurile de AI într-o firmă
1. Documente care devin înregistrări validate
Un PDF poate necesita OCR pentru obținerea textului, NLP pentru extragerea câmpurilor și reguli deterministe pentru verificarea formatului sau a totalurilor. Modelul generativ poate explica neconcordanțele, iar utilizatorul confirmă câmpurile înainte de salvare. Acesta este un sistem hibrid, nu o singură funcție „citește documente”.
2. Un CRM care pregătește următoarea acțiune
Aplicația poate grupa solicitări, rezuma istoricul și propune un răspuns din informațiile clientului accesibile utilizatorului. Un model clasic poate estima o probabilitate, iar un LLM poate redacta textul. Într-un CRM personalizat pentru firmă, stările, responsabilitățile și aprobările rămân reguli explicite ale produsului.
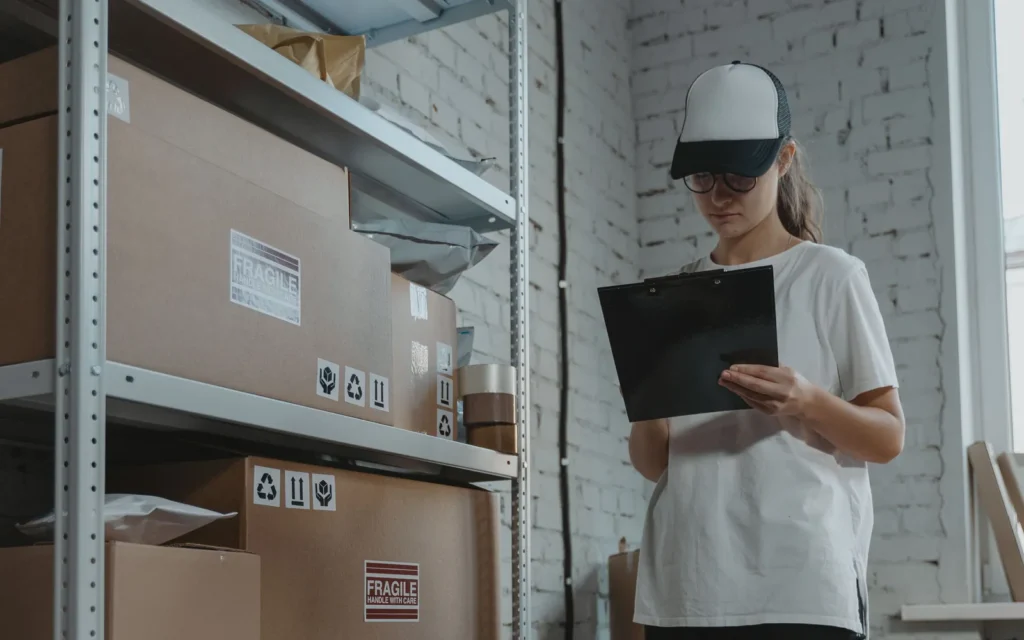
3. Control vizual într-un flux de depozit
O cameră poate furniza imagini unui detector de obiecte; rezultatul se corelează cu o comandă și se trimite unui operator dacă apare o abatere. Numărarea obiectelor nu înlocuiește automat verificarea codurilor sau a cantităților contractuale. Proiectele de automatizare business cu integrare AI leagă percepția de reguli, excepții și evidențe.
Fotografia de context prezintă o verificare umană într-un depozit; fluxul descris este un exemplu explicativ de arhitectură. În toate cele trei situații, AI contribuie la o etapă, iar aplicația organizează procesul complet.
Cum alegi tipul de AI potrivit pentru companie?
- Definește rezultatul: clasificare, estimare, extragere, generare sau executarea unei operațiuni. Formulează-l astfel încât să poată fi testat.
- Verifică datele: format, volum, calitate, acces, actualitate și drept de utilizare. Mai multe date nu înseamnă automat date potrivite.
- Compară cu o soluție simplă: reguli clare ori un model clasic pot rezolva o sarcină delimitată. Comparăm variantele pe același set de cazuri.
- Stabilește controlul: ce poate citi, propune și modifica sistemul, cine aprobă și cum se corectează erorile.
- Testează operarea: timp de răspuns, cost pe sarcină acceptată, integrare, monitorizare și posibilitatea schimbării modelului.
Aceste alegeri fac parte dintr-un proiect de dezvoltare software pentru procesele companiei. Alegerea modelului vine după definirea procesului și se verifică prin probe concrete. Pentru informații interne, aplicăm și controalele descrise în ghidul despre protecția datelor la integrarea AI.
Cum măsori dacă soluția funcționează bine?
Metrica trebuie să corespundă sarcinii. La clasificare analizăm inclusiv categoriile confundate; la extragere verificăm câmpurile corecte, greșite și lipsă; la căutare urmărim dacă sursa necesară este găsită. Pentru generare evaluăm respectarea cerinței, susținerea afirmațiilor și utilitatea rezultatului, nu doar fluența.
Exemplu didactic, cu date demonstrative: verificăm 200 de câmpuri așteptate din documente. Dacă 190 sunt extrase exact, iar 10 sunt greșite sau lipsesc, proporția câmpurilor corecte este 190 ÷ 200 = 95%. Această valoare nu arată câte documente sunt complet corecte și nici dacă o eroare privește un total critic sau o notă secundară.
Cum citim o rată de corectitudine: exemplu demonstrativ
- 200
Câmpuri așteptate și verificate individual.
- 190
Câmpuri extrase exact; 10 greșite sau lipsă.
- 95%
190 ÷ 200. Nu este procentul documentelor complet corecte.
Raportăm separat tipul erorii, timpul de verificare umană și costul rezultatului acceptat. Menținem un set de test și repetăm evaluarea când se schimbă modelul, instrucțiunile, documentele sau integrarea. Pentru bugetul complet, consultă ghidul despre costurile și mentenanța aplicațiilor AI.
Mini-glosar: model, antrenare, inferență și memorie
- Model: componenta care transformă anumite intrări în ieșiri, potrivit parametrilor și mecanismului ei.
- Antrenare: ajustarea parametrilor pe date, după un obiectiv de învățare.
- Inferență: folosirea modelului pentru a obține un rezultat la o intrare nouă.
- Context: informația pusă la dispoziția modelului pentru cererea curentă.
- Memorie a aplicației: informație păstrată și recuperată de sistem, cu reguli de acces și retenție.
- Agent: sistem care selectează acțiuni în raport cu informația și obiectivul său; poate folosi unul sau mai multe modele.
Întrebări frecvente despre tipurile de inteligență artificială
Câte tipuri de inteligență artificială există?
Numărul depinde de criteriu. ANI, AGI și ASI formează o clasificare după capacități; NLP și computer vision descriu domenii de prelucrare; generativ și discriminativ descriu familii de modele. Un sistem poate avea simultan mai multe etichete. Lista utilă păstrează criteriul vizibil.
AI generativă și AI predictivă sunt opuse?
Nu. „Predictiv” descrie folosirea pentru estimare sau clasificare, iar „generativ” are un sens legat de modelarea distribuțiilor și producerea de conținut. Există modele generative folosite la clasificare, iar o aplicație poate combina generarea cu predicții și calcule deterministe.
Un model lingvistic este automat un agent AI?
Nu. Modelul este o componentă. Agentul include mecanisme pentru alegerea acțiunilor și interacțiunea cu mediul, iar aplicația îi definește instrumentele, starea și permisiunile. Un model care redactează un răspuns nu primește automat dreptul de a modifica un CRM.
Un chatbot învață din fiecare conversație?
Comportamentul depinde de implementare. Păstrarea istoricului sau recuperarea unor informații nu reprezintă, prin ele însele, antrenare. Actualizarea parametrilor cere un proces distinct; utilizarea conversațiilor, retenția și accesul se verifică în configurația și documentația sistemului concret.
Un model mai mare este întotdeauna alegerea potrivită?
Alegem pe baza evaluării sarcinii, nu doar a dimensiunii. Un model mai mic poate acoperi o cerință delimitată cu resurse potrivite; altă cerință poate necesita capacități diferite. Comparăm calitatea, timpul, memoria, găzduirea și costul pe rezultat acceptat.
De unde începe un proiect AI pentru o firmă?
De la un proces clar, un responsabil și exemple reprezentative. Definim ce intră, ce trebuie să iasă și cine confirmă rezultatul. Apoi alegem tehnologia, verificăm datele și măsurăm pe un set de cazuri înainte de extinderea utilizării.