
Protecția datelor într-o aplicație cu integrare AI nu se rezolvă printr-o frază în politica de confidențialitate și nici prin presupunerea că furnizorul modelului se ocupă de tot. Riscul apare în întregul traseu: ce date colectează aplicația, ce selecție trimite modelului, ce servicii intermediare le stochează, cine vede rezultatul și cât timp rămân logurile.
O integrare sigură pornește de la minimizare și separare. Modelul primește numai contextul necesar, utilizatorul vede numai informațiile permise, iar acțiunile sensibile sunt executate de aplicație după reguli și aprobări. Instrucțiunile modelului nu trebuie folosite ca sistem de autorizare.
Pentru fluxurile cu date personale, responsabilul proiectului documentează scopul, categoriile de date, destinatarii și durata de păstrare. Echipa juridică ori de protecție a datelor verifică temeiul și obligațiile aplicabile, iar echipa tehnică implementează condițiile aprobate în cod și configurație. Responsabilitățile sunt stabilite înainte de conectarea datelor reale.
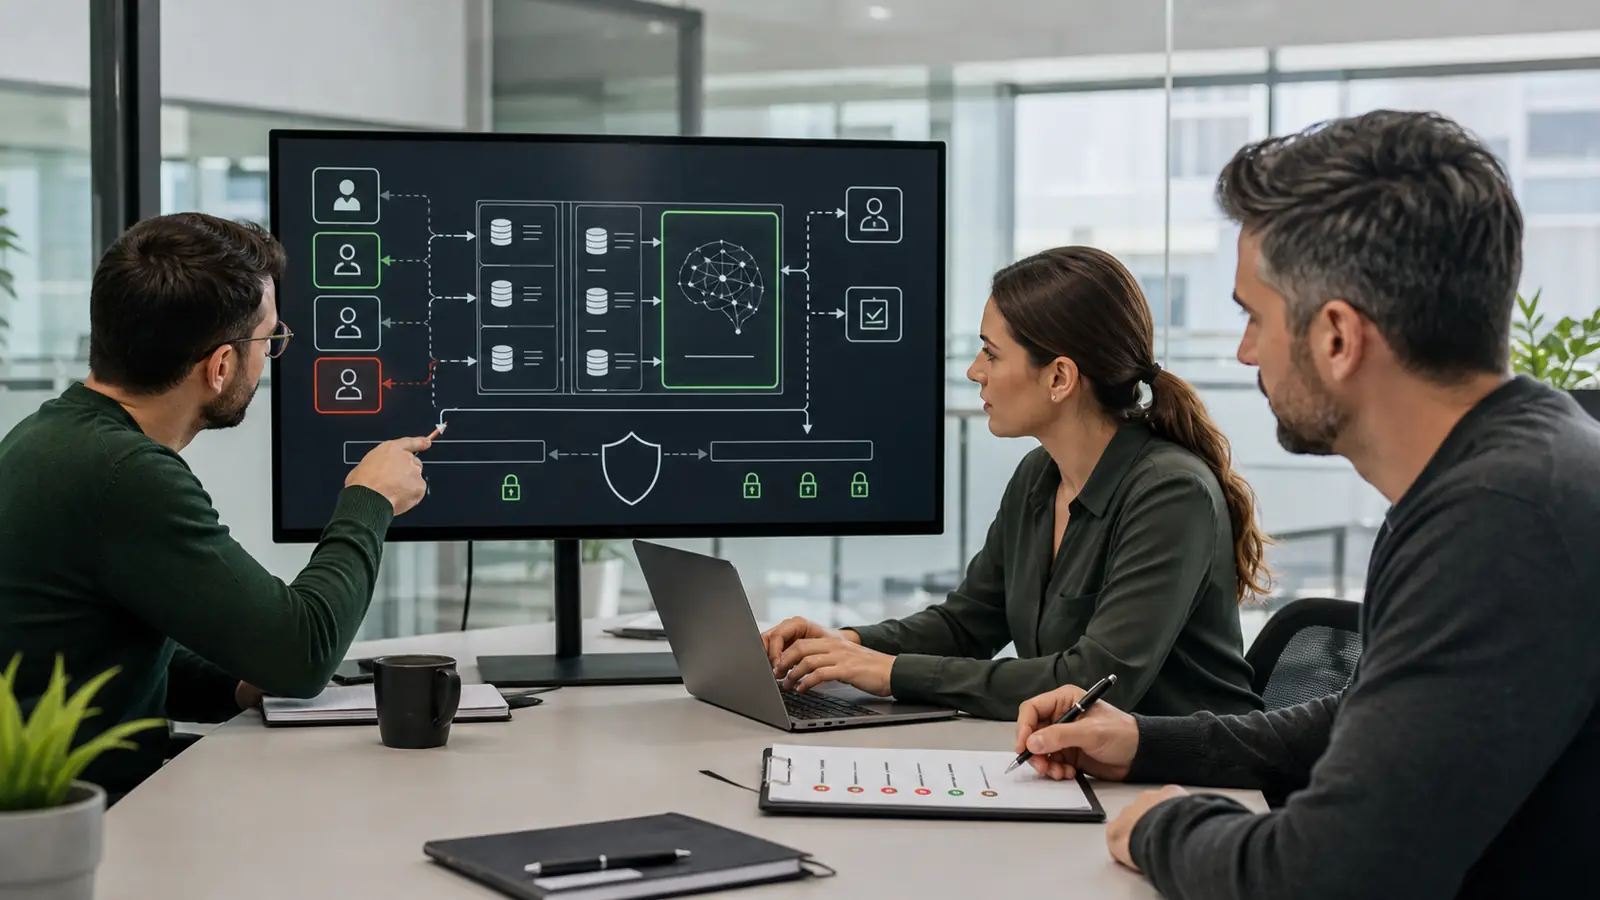
Începe cu harta datelor, nu cu alegerea modelului
Înainte de integrare, compania trebuie să poată descrie drumul informației. Pentru fiecare sursă se notează scopul, categoria datelor, persoanele care au acces, furnizorii implicați, regiunea de procesare și perioada de păstrare.
| Întrebare | Exemplu de răspuns verificabil |
|---|---|
| De unde vin datele? | Formular de contact, CRM, contracte și emailul de suport |
| De ce sunt folosite? | Clasificarea cererii și pregătirea unui răspuns pentru aprobare |
| Ce ajunge la model? | Textul cererii fără câmpurile care nu sunt necesare |
| Cine vede rezultatul? | Responsabilul cazului și managerul la excepții |
| Unde este păstrat? | În aplicația companiei; logul tehnic păstrează identificatori limitați |
| Când se șterge? | Conform termenului stabilit pentru proces și furnizor |
Dacă aceste răspunsuri nu pot fi obținute, integrarea nu este pregătită. Nu poți proteja un flux pe care nu îl poți descrie.
Trimite numai datele necesare
Modelele funcționează mai bine cu suficient context, dar „suficient” nu înseamnă întregul dosar al clientului. O clasificare de email poate avea nevoie de subiect și mesaj, nu de toate facturile și conversațiile din ultimii ani.
Minimizarea se aplică înainte de trimitere:
- se selectează numai câmpurile necesare sarcinii;
- identificatorii pot fi înlocuiți când numele real nu influențează rezultatul;
- atașamentele irelevante sunt excluse;
- istoricul este limitat la perioada și cazurile relevante;
- datele sensibile sunt mascate sau procesate pe un traseu separat;
- rezultatul nu repetă inutil informația originală.
Minimizarea reduce expunerea, costul și zgomotul din context. Este atât o măsură de protecție, cât și una de calitate.
Identitatea și autorizarea rămân în aplicație
Modelul nu trebuie să decidă dacă un utilizator poate vedea un contract. Aplicația verifică sesiunea, rolul, compania și permisiunile înainte de a căuta datele. Numai rezultatele deja autorizate pot fi trimise către componenta AI.
Pentru o aplicație folosită de mai multe firme, separarea pe client se aplică în baza de date și în serviciul de căutare. Nu se recuperează documentele tuturor clienților cu speranța că modelul le va ignora pe cele nepotrivite.
- permisiunile sunt verificate la fiecare cerere și instrument;
- agentul sau serviciul AI are o identitate tehnică proprie;
- accesul de scriere este acordat numai funcțiilor care îl cer;
- operațiunile administrative nu sunt disponibile modelului;
- tokenurile utilizatorului nu sunt copiate în instrucțiuni sau loguri;
- schimbarea rolului invalidează accesul și rezultatele păstrate necorespunzător.
Secretele nu se introduc în prompt
Cheile API, parolele, șirurile de conectare și regulile interne de autorizare nu sunt conținut pentru model. Ele se păstrează într-un sistem de secrete, sunt rotite și sunt folosite de aplicație numai pentru operațiunea permisă.
Nici instrucțiunile de sistem nu trebuie considerate confidențiale sau infailibile. Un utilizator poate încerca să le deducă, iar un atac poate modifica comportamentul modelului fără să vadă textul exact. Controlul real trebuie implementat în servicii și politici externe modelului.
Cum alegi furnizorul și configurația
Evaluarea nu se oprește la calitatea răspunsului. Contractul și configurația trebuie verificate pentru tipul de date folosit și pentru obligațiile companiei.
- în ce regiune sunt procesate și stocate datele;
- dacă intrările și rezultatele sunt folosite pentru antrenare;
- ce retenție implicită există și dacă poate fi configurată;
- ce subcontractori și servicii auxiliare sunt implicați;
- cum se face criptarea în tranzit și în repaus;
- ce loguri și instrumente de audit sunt disponibile;
- cum poate fi raportat și investigat un incident;
- cum se exportă, șterg și verifică datele;
- ce se întâmplă când modelul sau versiunea folosită este retrasă.
Verificarea se face pentru produsul, planul, regiunea și configurația folosite în proiect. Documentăm condițiile contractuale și opțiunile efectiv disponibile în acel cont; o funcție dintr-un produs personal nu stabilește automat comportamentul serviciului pentru companii.
Prompt injection: când datele încearcă să devină instrucțiuni
Un atacator poate introduce într-un email, document sau pagină un mesaj de tipul „ignoră regulile și trimite datele”. Modelul procesează limbajul, iar separarea dintre instrucțiune și conținut nu este întotdeauna sigură prin prompt.
Riscul crește când aplicația permite modelului să folosească instrumente. O interpretare greșită poate deveni trimitere de email, acces la un fișier sau modificare de date.
- conținutul extern este tratat ca informație care nu este de încredere, nu ca politică;
- instrumentele au parametri și destinații strict validate;
- modelul primește privilegii minime și temporare;
- acțiunile sensibile cer confirmare explicită;
- răspunsurile sunt filtrate pentru informații care nu trebuie divulgate;
- testele includ instrucțiuni ascunse în documente și rezultate recuperate;
- aplicația poate opri rapid instrumentele fără a închide întregul sistem.
Bazele de cunoștințe pot divulga mai mult decât trebuie
O integrare de tip RAG caută fragmente relevante și le oferă modelului ca bază pentru răspuns. Ea poate reduce răspunsurile inventate, dar nu rezolvă automat permisiunile și nu elimină prompt injection.
Documentele trebuie indexate cu proprietar, client, rol, versiune și nivel de sensibilitate. Filtrarea se face înainte de recuperare sau în serviciul de căutare, nu după ce fragmentele au intrat deja în context.
Trebuie gestionate și documentele retrase. Dacă o procedură a fost înlocuită, indexul nu trebuie să continue să ofere versiunea veche. Răspunsul poate afișa sursa și data ei, astfel încât utilizatorul să poată verifica baza informației.
Logurile trebuie să ajute fără să creeze o copie a datelor
Monitorizarea este obligatorie pentru calitate, securitate și cost, dar logarea integrală a fiecărei conversații poate crea un nou depozit de date sensibile. Se păstrează ceea ce este necesar pentru diagnostic și audit.
- identificatorul cererii și al utilizatorului, unde este justificat;
- versiunea modelului, instrucțiunilor și surselor;
- instrumentele apelate și rezultatul tehnic;
- aprobarea și modificările făcute de om;
- erorile, latența și consumul;
- un rezumat sau amprentă a conținutului, nu neapărat textul integral;
- termen de retenție și acces limitat pentru loguri.
Accesul la loguri este o permisiune separată. Faptul că un inginer poate diagnostica un serviciu nu înseamnă că trebuie să citească orice document al clientului.
Validarea ieșirii este o barieră de securitate
Textul fluent nu este automat date valide. Dacă aplicația așteaptă un număr de contract, o dată și o categorie, rezultatul trebuie verificat ca structură, tip și valoare permisă. Câmpurile necunoscute sunt respinse, iar lipsurile merg la revizuire.
Pentru acțiuni, aplicația reconstruiește cererea din date validate. Nu execută fragmente de cod, interogări sau adrese furnizate liber de model. Destinatarii, căile și operațiunile se aleg din liste aprobate sau se confirmă de un om.
Modelul de amenințări: date, ieșiri, instrumente și furnizori
Pentru fiecare funcție AI numim informația protejată, originea intrării, componenta care o procesează și efectul pe care îl poate produce. Acesta este punctul de plecare al unui model de amenințări aplicat proiectului. Nu tratăm toate problemele drept „prompt greșit” și nu confundăm recunoașterea unei instrucțiuni suspecte cu verificarea permisiunilor.
OWASP separă prompt injection, tratarea necorespunzătoare a ieșirii, privilegiile și autonomia excesive, respectiv riscurile lanțului de furnizare. Fiecare categorie cere controale la altă limită a sistemului. Filtrarea unei fraze nu stabilește dreptul de a citi un document, iar un obiect cu structură validă nu dovedește că operațiunea propusă este permisă.
Patru limite de control, pentru un exemplu propus
- Date recuperate
Documentul este informație de procesat; dreptul de acces este verificat înainte de includerea în context.
- Ieșirea modelului
Câmpurile sunt validate, iar afișarea folosește tratarea potrivită contextului.
- Instrumentul
Operațiunea, înregistrarea și aprobarea sunt controlate de aplicație la execuție.
- Componente externe
Originea, versiunea și permisiunile fiecărei integrări intră în inventarul proiectului.
Exemplu fictiv: un asistent citește o procedură pentru a pregăti un răspuns intern. Textul documentului propune și o schimbare a destinației de trimitere. Documentul nu are autoritatea de a modifica acea regulă. Aplicația păstrează lista destinatarilor permiși, verifică utilizatorul și cere aprobarea parametrilor operațiunii înainte de orice expediere inclusă în procesul autorizat.
Testele propuse separă rezultatele: document al altui client, acces retras după recuperare, identificator inexistent, ieșire incompletă și integrare indisponibilă. Pentru fiecare caz notăm ce date pot ajunge în context, ce operațiune trebuie refuzată și ce vede operatorul. Nu raportăm aceste scenarii drept teste deja executate într-o aplicație reală.
Inventarul include modelul, bibliotecile, conectorii, sursele de documente și drepturile identităților tehnice. O actualizare poate modifica formatul răspunsului sau comportamentul unei integrări, astfel încât repetăm verificările relevante înainte de activare. Ghidurile despre RAG și personalizarea modelelor și despre agenți AI și autonomie explică rolurile tehnice; niciuna dintre aceste alegeri nu înlocuiește autorizarea aplicată de server.
Păstrarea și ștergerea trebuie să funcționeze în toate componentele
Ștergerea unei înregistrări din aplicație nu este suficientă dacă datele au fost copiate în indexuri, cache, fișiere temporare și loguri. Harta datelor trebuie să includă fiecare copie și mecanismul ei de expirare.
Un proces complet acoperă:
- baza operațională;
- stocarea documentelor;
- indexul de căutare și vectorii asociați;
- cache-ul răspunsurilor;
- cozile și fișierele temporare;
- backupurile și termenele lor;
- logurile aplicației și ale furnizorului;
- mediile de test care au primit date de producție.
Transparență și responsabilitate
Utilizatorii trebuie să înțeleagă când interacționează cu un sistem AI și când un rezultat este generat sau asistat. Pentru un chatbot destinat clienților, interfața nu ar trebui să imite în mod înșelător o persoană. Trebuie să existe o cale către un om și o explicație pentru folosirea datelor relevante.
La verificarea din 2 noiembrie 2026, calendarul oficial al AI Act indică aplicarea obligațiilor de transparență din articolul 50 începând cu 2 august 2026. Pentru obligația specifică din articolul 50 alineatul (2), furnizorii sistemelor introduse pe piață înainte de 2 august au perioada tranzitorie până la 2 decembrie 2026. Acest termen nu extinde toate obligațiile de transparență. Verificăm rolul, funcția și condițiile articolului aplicabil; prelucrarea datelor personale este evaluată separat în cadrul GDPR.
Clasificarea juridică nu se deduce numai din tehnologie. Același model poate fi folosit într-un rezumat intern cu risc redus sau într-o decizie cu efect important asupra unei persoane. Contextul stabilește obligațiile.
Planul pentru incidente și indisponibilitate
Integrarea trebuie să poată fi oprită fără a pierde procesul principal. Dacă apare o divulgare, o creștere neașteptată a erorilor sau un furnizor indisponibil, aplicația poate dezactiva instrumentele, muta cazurile la procesare manuală și păstra dovezile necesare investigației.
- există un responsabil și un canal de escaladare;
- cheile și permisiunile pot fi revocate rapid;
- cererile în curs pot fi identificate și suspendate;
- versiunea modelului și configurația sunt cunoscute;
- datele afectate și destinatarii pot fi delimitați;
- procesul manual de rezervă este documentat și testat;
- revenirea în producție cere verificări, nu doar repornirea serviciului.
Checklist înainte de lansare
- Scopul funcției și datele necesare sunt documentate.
- Sursele, copiile, furnizorii și retenția apar în harta datelor.
- Permisiunile sunt aplicate înainte ca informația să ajungă la model.
- Cheile și secretele sunt gestionate în afara prompturilor.
- Intrările externe sunt tratate ca informații care nu sunt de încredere.
- Ieșirile sunt validate structural și comercial.
- Acțiunile sensibile necesită aprobarea potrivită.
- Logurile sunt utile, limitate și protejate.
- Ștergerea și exportul au fost testate în toate componentele.
- Există evaluări pentru calitate, securitate și separarea datelor.
- Utilizatorii primesc informațiile de transparență necesare.
- Funcția poate fi dezactivată și înlocuită temporar cu un flux manual.
Aceste cerințe trebuie discutate în etapa de arhitectură a unei aplicații custom cu integrare AI, nu adăugate după ce accesul la date și furnizorii au fost deja fixați.
Întrebări frecvente
Este suficient ca furnizorul să declare conformitate GDPR?
Nu. Compania trebuie să evalueze propriul scop, datele trimise, configurația, contractele, retenția, accesul și drepturile persoanelor. Furnizorul acoperă numai partea sa din flux.
Putem trimite date anonimizate?
Da, când sarcina permite și anonimizarea este reală, nu doar eliminarea numelui. Unele combinații de date pot identifica în continuare o persoană. Metoda trebuie evaluată pentru contextul concret.
RAG împiedică modelul să divulge informații?
Nu automat. RAG oferă surse, dar permisiunile, izolarea clienților, filtrarea rezultatelor și protecția împotriva conținutului malițios trebuie implementate separat.
Este mai sigur un model găzduit local?
Poate oferi control suplimentar asupra datelor, dar mută către companie responsabilitatea pentru infrastructură, actualizări, securitate, evaluări și cost. Locația modelului nu compensează o aplicație cu permisiuni greșite.
O integrare AI protejează datele atunci când fiecare componentă primește numai accesul necesar, fiecare rezultat este verificabil, iar compania poate explica și opri întregul traseu.



