RAG înseamnă Retrieval-Augmented Generation: sistemul caută informații relevante într-o colecție de documente și le folosește pentru a formula răspunsul. Pentru o firmă, aceasta este o arhitectură utilă când asistentul trebuie să consulte proceduri, fișe tehnice, manuale sau politici interne aprobate.
Un chatbot pentru documentele firmei nu începe cu încărcarea tuturor fișierelor într-un singur loc. Începe cu alegerea surselor, stabilirea accesului și definirea întrebărilor pe care trebuie să le rezolve. Aceste cerințe fac parte din dezvoltarea unei aplicații AI pentru firmă, împreună cu integrarea și evaluarea rezultatelor.
Cum funcționează un chatbot RAG?
Documentele aprobate sunt pregătite pentru căutare. Sistemul păstrează informații despre sursă, versiune și acces, apoi organizează conținutul în fragmente care pot fi regăsite. Când utilizatorul pune o întrebare, sunt selectate fragmente relevante și permise acelui utilizator. Modelul primește contextul necesar pentru formularea răspunsului.
Documentația OpenAI pentru căutarea în fișiere descrie regăsirea semantică și pe bază de cuvinte cheie. Prima ajută la identificarea sensului cererii; a doua este importantă pentru denumiri și identificatori exacți. În implementare, verificăm dacă rezultatele găsite conțin efectiv informația cerută, înainte de a evalua formularea finală.
Traseul unei întrebări într-un sistem RAG
- Documente aprobate
Versiuni, responsabili și drepturi.
- Regăsire relevantă
Fragmente potrivite întrebării și utilizatorului.
- Răspuns cu surse
Explicație legată de materialul găsit.
Ce documente merită incluse în baza de cunoștințe?
Alegem documente cu proprietar clar și utilizare concretă: proceduri de lucru, întrebări rezolvate de echipa de suport, manuale de produse sau condiții comerciale aprobate. Materialele contradictorii, ciornele și documentele retrase sunt separate înainte de indexare. Calitatea colecției influențează direct informația disponibilă asistentului.
- Identitate: titlul documentului, tipul, produsul sau procesul la care se referă.
- Versiune: data intrării în vigoare și documentul pe care îl înlocuiește.
- Responsabil: persoana care aprobă conținutul și actualizările.
- Acces: echipele și utilizatorii care au dreptul să consulte materialul.
- Structură: secțiuni, tabele și anexe care trebuie păstrate inteligibil la extragere.
Într-un proiect de digitalizare a documentelor și proceselor interne, această inventariere poate evidenția și lipsuri operaționale. Dacă două departamente folosesc versiuni diferite ale aceleiași proceduri, stabilim mai întâi sursa validă. Chatbotul trebuie construit peste o regulă documentară clară.
Exemplu: căutarea unei informații tehnice
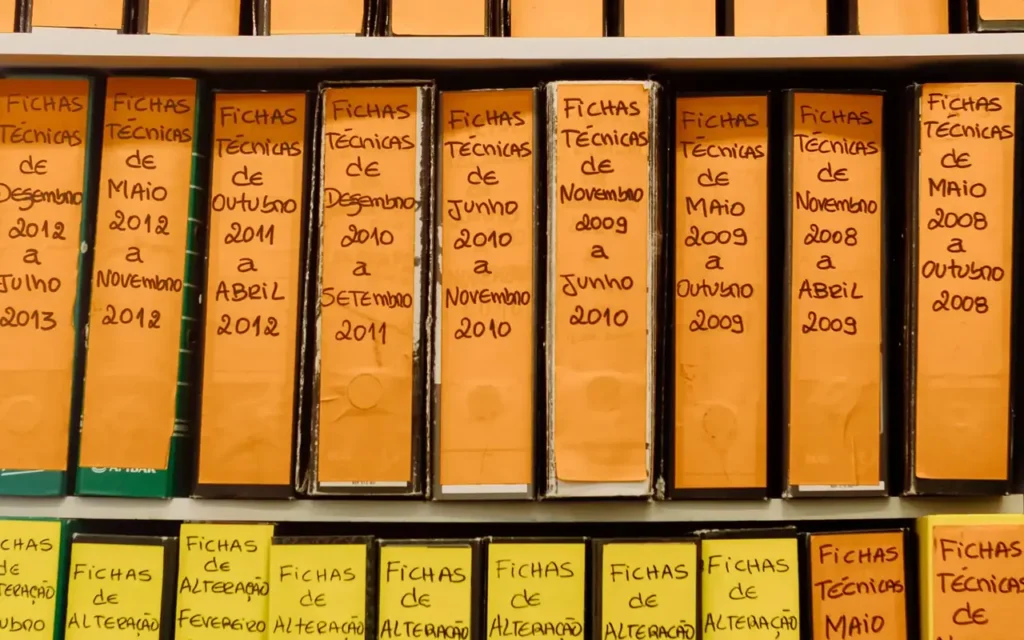
Un coleg întreabă ce accesorii sunt necesare pentru montarea unui anumit echipament. Sistemul identifică modelul, caută în manualul corespunzător și selectează secțiunea relevantă. Răspunsul indică accesoriile descrise acolo și sursa consultată. Dacă există mai multe versiuni, cere identificarea exactă a produsului.
Nu combinăm automat instrucțiuni de la modele diferite doar pentru că au termeni asemănători. Testele includ coduri apropiate, documente în mai multe limbi și întrebări incomplete. Pentru decizii tehnice care cer validarea unui specialist, răspunsul pregătește informațiile și direcționează cererea către persoana responsabilă.
Un asistent public poate folosi documentația aprobată pentru clienți, în timp ce unul intern consultă alte materiale. Un website cu informații clare despre produse și servicii rămâne sursa publică de prezentare. Documentele interne nu devin publice prin simpla conectare a aceluiași model AI.
Accesul pe roluri se aplică înainte de răspuns
Identitatea utilizatorului și drepturile lui sunt verificate de aplicație. Căutarea trebuie limitată la documentele permise înainte ca fragmentele să fie trimise modelului. O instrucțiune de tipul „nu divulga documente confidențiale” nu înlocuiește filtrarea tehnică a surselor și verificarea drepturilor pe server.
Același principiu se aplică citărilor și previzualizărilor: legătura către document trebuie să respecte accesul sursei. Jurnalul poate păstra identificatorii materialelor consultate și rezultatul evaluării, fără să copieze inutil conținut sensibil. Alegem datele trimise și păstrate în funcție de necesitatea procesului.
Cum păstrăm informațiile actuale?
O bază de cunoștințe are un ciclu de viață. Când apare o versiune nouă, actualizăm metadatele, înlocuim materialul vechi și verificăm că întrebările relevante folosesc noua informație. La retragerea unui document, verificăm atât eliminarea din căutare, cât și eventualele copii sau rezultate memorate de aplicație.
Ciclul de viață al documentației
- Publicare internă
Aprobare și indexare.
- Modificare
Înlocuirea versiunii și reindexare.
- Retragere
Eliminarea accesului și verificarea regăsirii.
Definim cine declanșează actualizarea și cum sunt raportate erorile de indexare. O încărcare incompletă nu trebuie prezentată ca o sursă disponibilă integral. Pentru documentele cu intrare în vigoare la o anumită dată, căutarea trebuie să distingă versiunea aplicabilă de materialele pregătite pentru viitor.
Evaluăm separat căutarea și răspunsul
Construim un set de întrebări din munca reală a echipei și notăm sursa corectă pentru fiecare. Prima verificare urmărește dacă sistemul găsește documentul și pasajul necesar. A doua urmărește dacă răspunsul reproduce fidel informația, păstrează condițiile și indică sursa potrivită.
Includem întrebări care nu au răspuns în colecție. Comportamentul cerut este clar: asistentul cere o precizare sau transmite solicitarea unui coleg, fără să completeze golurile cu reguli comerciale ori tehnice inventate. Verificăm și surse contradictorii, documente retrase, acces insuficient și cereri care încearcă să schimbe instrucțiunile aplicației.
Indicatorii sunt proporția pasajelor corecte regăsite, fidelitatea răspunsurilor, calitatea citărilor, transferurile necesare și timpul până la informația utilă. Testele se repetă după modificarea colecției sau a mecanismului de căutare. Un rezultat bun pe câteva întrebări alese nu înlocuiește verificarea scenariilor reprezentative.
RAG, antrenare și integrarea în activitatea firmei
Interfața de răspuns trebuie să ajute utilizatorul să verifice informația: titlul sursei, secțiunea consultată și data versiunii sunt mai utile decât o listă de fișiere fără context. Pentru întrebări cu mai multe condiții, evaluăm dacă pasajele găsite acoperă toate componentele cererii. Un document relevant pentru produs, dar care nu precizează condiția întrebată, nu este suficient.
Păstrăm și un mecanism de feedback pentru echipă. Utilizatorul poate semnala un răspuns incomplet, iar responsabilul verifică sursa și identifică etapa care trebuie corectată: documentația, indexarea, căutarea sau formularea. Corectăm cauza, apoi repetăm scenariul în setul de evaluare.
RAG furnizează context la momentul întrebării. Ajustarea unui model prin antrenare este o intervenție diferită, orientată spre comportamente și tipare de răspuns. Pentru documente care se actualizează și necesită surse verificabile, proiectăm explicit regăsirea, versiunile și accesul, nu tratăm antrenarea ca pe un substitut al administrării documentelor.
Experiența din proiectele de aplicații realizate de WebHat ajută la conectarea interfeței cu procesele firmei. Pentru un sistem RAG, livrabilele includ colecția aprobată, regulile de acces, scenariile de evaluare și responsabilitatea actualizării. Astfel, asistentul devine un instrument de lucru administrabil.
Întrebări frecvente despre chatboturi pentru documente
Putem folosi PDF-uri și manuale existente?
Da. Verificăm extragerea textului, structura secțiunilor și lizibilitatea. Documentele scanate pot necesita recunoașterea textului. Alegem versiuni aprobate și testăm întrebări concrete pentru a confirma că informația relevantă este regăsită corect.
RAG înseamnă că modelul este antrenat pe toate fișierele?
Nu. În arhitectura RAG, aplicația caută fragmente relevante și le furnizează drept context pentru cererea curentă. Configurația serviciilor și politica de administrare a datelor sunt stabilite separat în proiect.
Poate fiecare departament să vadă alte documente?
Da, prin autentificare și filtrarea surselor conform drepturilor. Controlul este aplicat în integrare, inclusiv pentru citări și documentele deschise din răspuns. Testarea include utilizatori cu roluri diferite și materiale cu acces restricționat.
Ce pregătim pentru un proiect RAG?
Documentele aprobate, proprietarii lor și întrebări reprezentative. Pentru dezvoltarea unui chatbot conectat la documentele firmei, stabilim apoi sursele, accesul, actualizările și criteriile prin care verificăm răspunsurile înainte de lansare.